Finalité
Voyez quand un utilisateur vous lit via ChatGPT
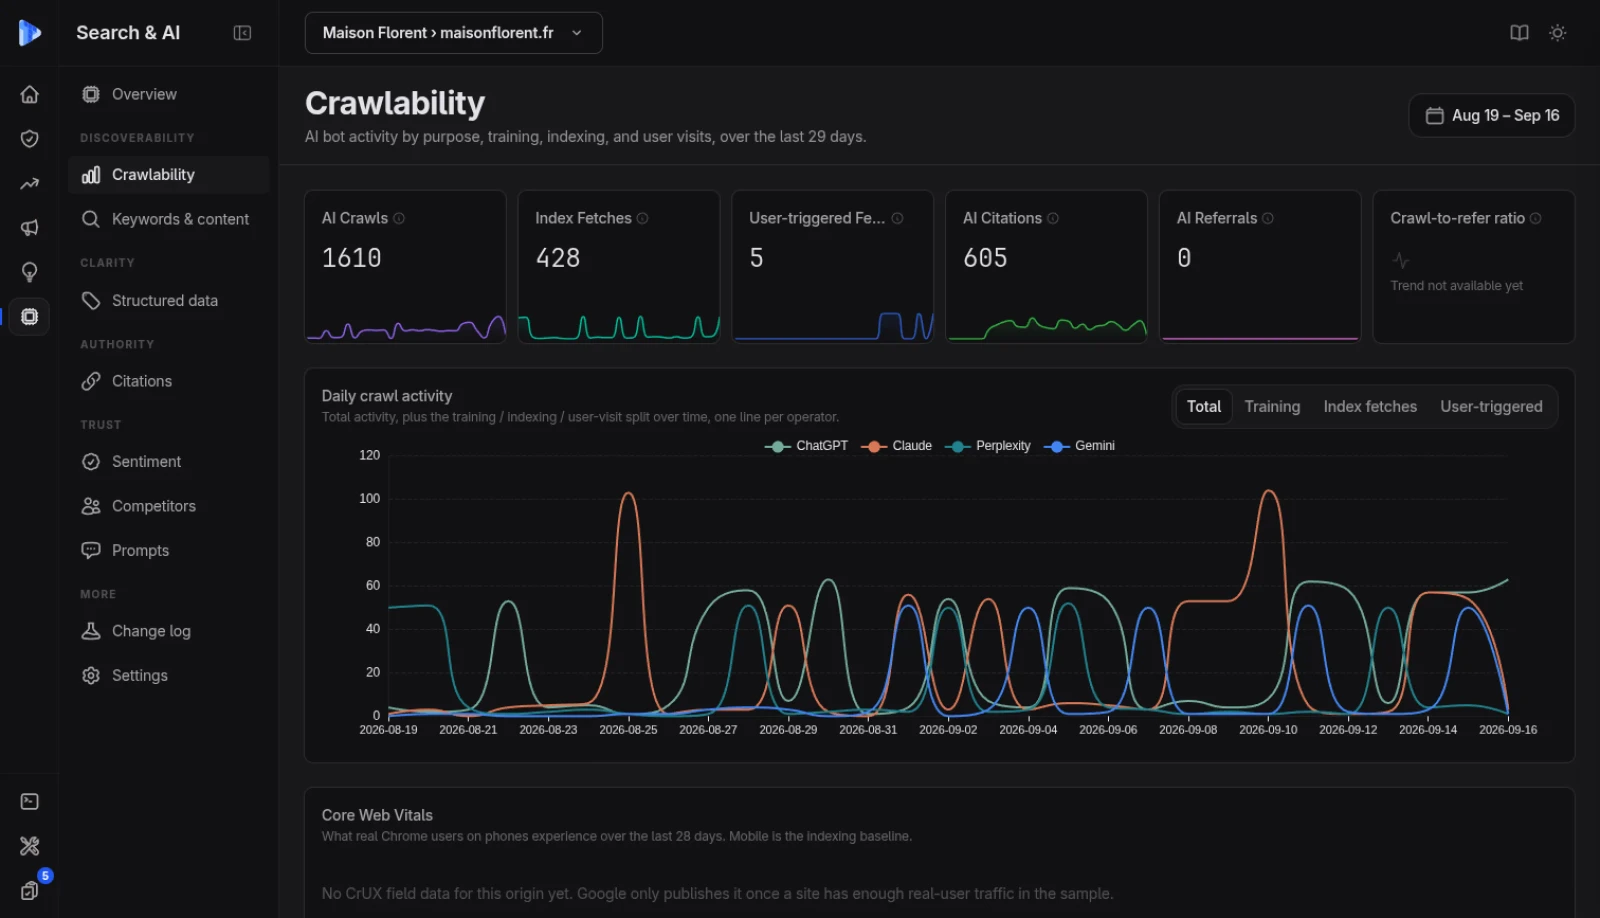
Chaque crawler est classé par finalité : entraînement, indexation, ou lecture à la demande pour répondre à la question qu'un utilisateur vient de poser.
À retenir
Quand un utilisateur pose sa question à ChatGPT ou Perplexity, c'est le moteur qui vient lire votre page, et aucun clic n'arrive jusqu'à vous. Cette visite n'existe pas dans GA4. Elle existe dans vos logs, avec le moteur, la finalité et l'heure, et TrustData la relie à la citation qui a suivi, ou non.
Get Found
Un moteur qui répond à un utilisateur lit votre page à sa place, sans navigateur ni JavaScript. GA4 ne le voit pas. Le tracking first-party côté serveur l'enregistre.
Chaque crawler est classé par finalité : entraînement, indexation, ou lecture à la demande pour répondre à la question qu'un utilisateur vient de poser.
Chaque crawler connu est rattaché au moteur qu'il alimente : OpenAI, Claude, Gemini, Perplexity, Mistral, DeepSeek, Meta AI et les autres.
Le délai entre premier crawl et première citation, par page et par moteur sur 90 jours, dit si une modification a produit son effet.
Vos pages stratégiques bloquées dans robots.txt, listées une par une : une page bloquée n'est jamais citée, quel que soit le reste du site.
Crawls et citations sont rapprochés page par page et moteur par moteur. Chaque cas appelle une action différente.
Le délai entre les deux est mesuré, et sa distribution par moteur indique la vitesse à laquelle votre secteur est repris.
Le moteur a lu la page sans la citer en 90 jours : le problème est le contenu, l'audit de page est l'étape suivante.
Le moteur cite une page qu'il n'a jamais lue : la citation vient de ses données d'entraînement, et modifier la page n'y changera rien.
Moins de 14 jours d'historique, et la ligne le dit, au lieu d'afficher un zéro qui n'en est pas un.
Les données de crawl ne servent que si elles changent une décision. Voici les trois qu'elles changent le plus souvent.
La plupart des blocages sont hérités, règle anti-scraping ou réglage de plugin par défaut. Vous voyez quel crawler est refusé sur quelle page.
Jamais crawlé est un problème d'accès, crawlé sans citation un problème de contenu. Les deux ne se corrigent pas au même endroit.
Le rapport entre crawls et visites référées, par moteur, désigne celui qui vous lit beaucoup et ne vous envoie personne.
La plupart des équipes lisent les logs à la main ou supposent que tout va bien.
Visites de crawlers IA identifiées côté serveur
TrustData
Google Analytics 4
Autres outils
Outils de logs, non classésCrawler rattaché au moteur qu'il alimente
TrustData
Google Analytics 4
Autres outils
Finalité du crawl : entraînement, index ou lecture à la demande
TrustData
Google Analytics 4
Autres outils
robots.txt vérifié page par page
TrustData
Google Analytics 4
Autres outils
À la mainDélai entre crawl et citation
TrustData
Google Analytics 4
Autres outils
| Fonctionnalité | TrustData | Google Analytics 4 | Autres outils |
|---|---|---|---|
| Visites de crawlers IA identifiées côté serveur | Outils de logs, non classés | ||
| Crawler rattaché au moteur qu'il alimente | |||
| Finalité du crawl : entraînement, index ou lecture à la demande | |||
| robots.txt vérifié page par page | À la main | ||
| Délai entre crawl et citation |
Questions fréquentes
Parce que les crawlers IA n'exécutent pas de JavaScript, et que GA4 ne mesure que ce qu'un navigateur exécute. TrustData les détecte côté serveur, dans la couche de tracking first-party, qui inspecte le user-agent de chaque requête avant tout script. C'est pourquoi les crawlers n'apparaissent pas dans la plupart des dashboards, même pas à zéro : la mesure n'a jamais eu lieu.
Parce que les décisions sont différentes. Un crawler d'entraînement construit un corpus qui sera figé dans un modèle futur. Un crawler d'index maintient un index qui répond aux questions aujourd'hui. Une lecture à la demande a lieu parce qu'un utilisateur vient de poser une question et que le moteur est allé lire votre page pour y répondre. Bloquer l'entraînement en laissant passer la lecture à la demande est une position défendable sur vos droits de contenu. Bloquer les trois parce qu'une règle générique les a pris au passage est le cas le plus fréquent, et cela vous coûte des citations que personne n'a décidé de perdre.
La citation vient le plus souvent des données d'entraînement du modèle, pas d'une lecture en direct. La distinction compte : modifier la page ne changera pas ce que dit le modèle, et la citation peut disparaître à la prochaine mise à jour du modèle, que vous ne contrôlez pas. C'est aussi pourquoi les sondes tournent avec et sans recherche web. Une marque forte sans recherche et faible avec est connue du modèle mais n'est pas lue ; l'inverse veut dire que le modèle ne la connaît pas encore.
Les crawls et les citations sont rapprochés par page et par moteur sur 90 jours d'historique, en conservant les pages où un seul des deux existe. Quand les deux existent, le délai entre le premier crawl et la première citation est mesuré. Quand un seul existe, la ligne est classée : crawlée sans citation, ou citée sans crawl. Sous 14 jours d'historique, rien n'est conclu et la ligne l'indique.
Pour la lecture à la demande, oui, entièrement : un moteur qui ne peut pas lire une page ne peut pas la citer, et l'échelon Get Found plafonne à faible dès que la moitié de vos pages stratégiques bloquent les bots IA. Pour l'entraînement, c'est un arbitrage légitime que certaines marques font en connaissance de cause. Le rôle de TrustData est de vous montrer que le choix a bien été fait. Le cas le plus fréquent n'est ni l'un ni l'autre : une règle écrite il y a des années pour un autre problème, qui refuse encore les crawlers qui comptent aujourd'hui.
Essai gratuit 14 jours
Essai gratuit 14 jours. Le suivi des crawlers fait partie de la Visibilité IA, incluse dans chaque formule.