Prompts ICP
Évitez d'inventer une liste de prompts de zéro
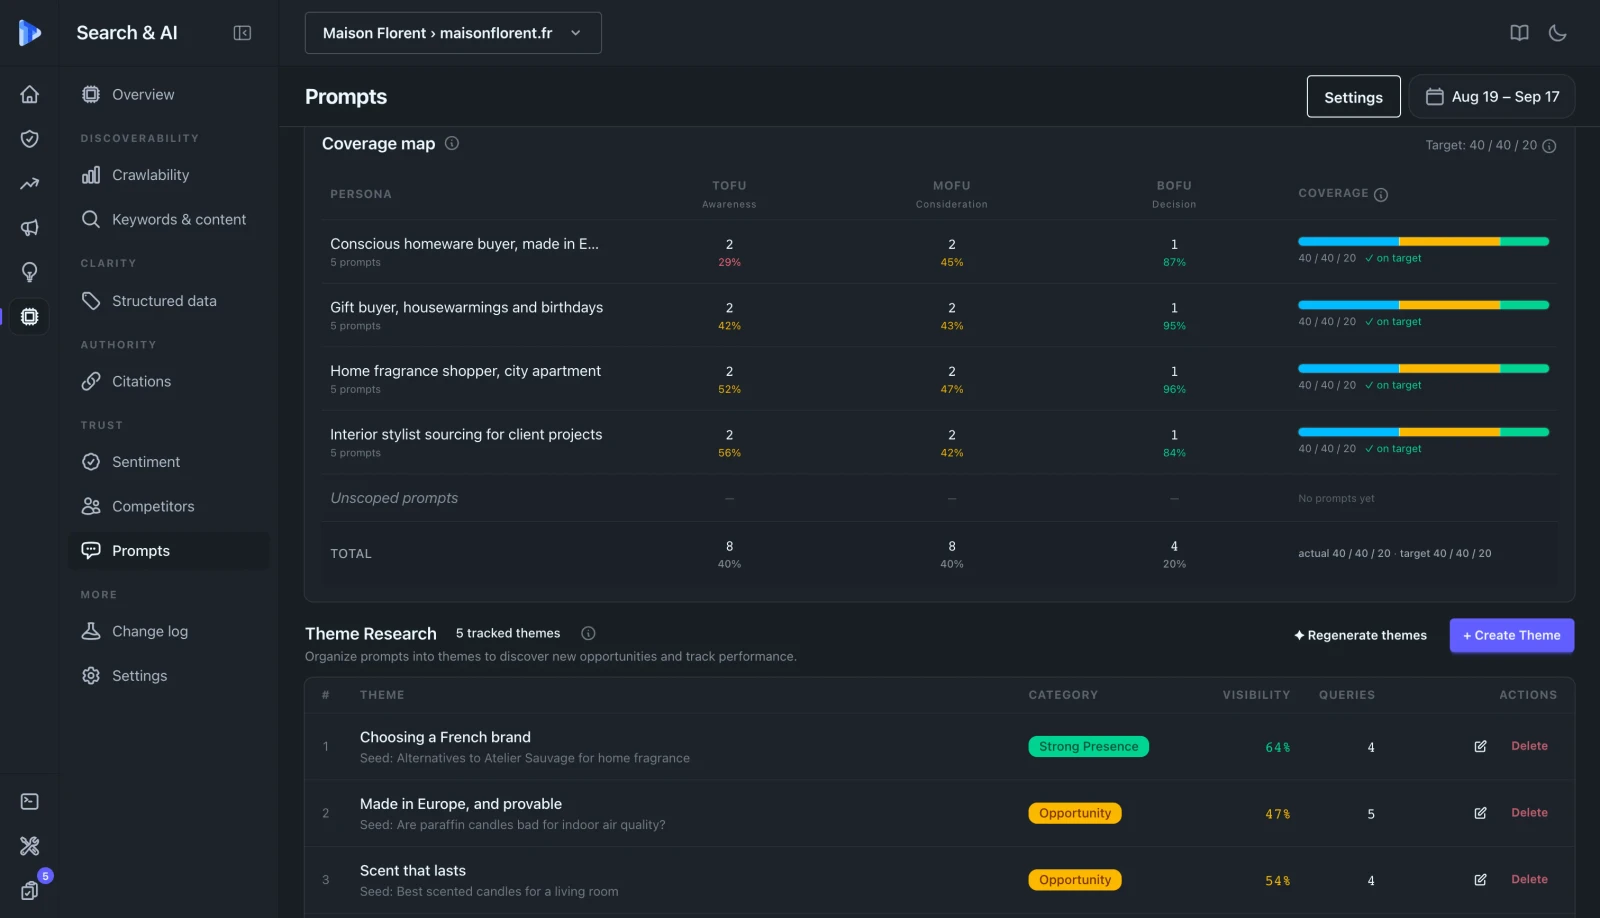
Définissez votre audience une fois et les prompts sont générés depuis ces personas et la demande observée, puis proposés en lot.
À retenir
La stabilité d'un prompt est la similarité médiane par paires des listes de marques renvoyées sur ses sondes récentes. Sous le plancher, le prompt est signalé plutôt que tracé, car une courbe tirée à travers du bruit ressemble exactement à une courbe tirée à travers un résultat.
Couverture
Deviner ses prompts produit une liste qui flatte la marque. Ceux-ci viennent de votre audience et de la demande réelle.
Définissez votre audience une fois et les prompts sont générés depuis ces personas et la demande observée, puis proposés en lot.
Marque directe, catégorie, comparaison et point de douleur correspondent à des étapes différentes, échouent différemment et sont notés à part.
La similarité médiane par paires des listes de marques sur les sondes récentes, donc un score bas rend toute tendance qu'on en tire du bruit.
0 à 1 sur quatre axes : distinction face aux concurrents, stabilité du taux de mention, lien avec une décision prise, fraîcheur de sondage.
Chaque chiffre d'un prompt remonte aux sondes derrière lui, et les réponses sont conservées.
Chaque prompt tourne avec recherche web en direct et sans. L'écart sépare ce que le modèle sait de ce qu'il vient de lire.
La réponse derrière chaque résultat est stockée et lisible. Un taux de mention qu'on ne peut pas ouvrir se prend sur parole.
Taux de mention, position et sentiment dans le temps par prompt, pour qu'une baisse de l'agrégat se trace aux questions qui ont bougé.
50 prompts suivis sur Measure jusqu'à 400 sur Prove, contre des budgets mensuels de 3 000 à 24 000, plafonnés plutôt que facturés au-delà.
Les prompts se priorisent, se mettent en pause et s'éditent en masse : un jeu de prompts est une liste vivante, pas une étape de setup.
Le taux de mention de marque sur l'ensemble des prompts note l'échelon 5,avec le nombre d'écarts AI Overview remonté à côté comme preuve.
C'est la métrique qui décide si le reste des chiffres veut dire quelque chose.
Un prompt au score de reproductibilité bas bouge de façon persuasive sans rien dire. Publier ce score à côté fait toute la différence.
Nous affirmons que des prompts ancrés sur les personas renvoient des listes plus stables. La reproductibilité le prouve ou l'infirme sur vos données.
Courir après une baisse de taux de mention sur un prompt instable coûte un sprint et ne produit rien : la baisse n'a jamais existé.
La différence tient à l'origine des prompts et à la connaissance de leur stabilité.
Prompts générés depuis l'ICP et la demande réelle
TrustData
Google Analytics 4
Autres outils
Saisie manuelleScore de reproductibilité par prompt
TrustData
Google Analytics 4
Autres outils
Score de qualité sur quatre axes
TrustData
Google Analytics 4
Autres outils
Avec et sans recherche sur le même calendrier
TrustData
Google Analytics 4
Autres outils
RarementRéponse complète conservée et lisible
TrustData
Google Analytics 4
Autres outils
Parfois| Fonctionnalité | TrustData | Google Analytics 4 | Autres outils |
|---|---|---|---|
| Prompts générés depuis l'ICP et la demande réelle | Saisie manuelle | ||
| Score de reproductibilité par prompt | |||
| Score de qualité sur quatre axes | |||
| Avec et sans recherche sur le même calendrier | Rarement | ||
| Réponse complète conservée et lisible | Parfois |
Questions fréquentes
C'est la pratique consistant à exécuter un jeu fixe de questions contre les moteurs IA à intervalles réguliers et à enregistrer comment votre marque apparaît dans les réponses. TrustData exécute chaque prompt dans deux modes, avec recherche web en direct et sans, sur quatre types de question, et conserve la réponse complète derrière chaque résultat. Le nombre de prompts va de 50 sur Measure à 400 sur Prove, contre des budgets de sondes mensuels de 3 000 à 24 000.
C'est la similarité médiane deux à deux entre les listes de marques qu'un moteur a renvoyées sur les sondes récentes d'un prompt. Si le moteur renvoie à peu près le même ensemble de marques à chaque fois, le prompt est stable et une tendance qu'on en tire veut dire quelque chose. Si l'ensemble change à chaque exécution, le prompt est instable et sa courbe est du bruit qui ressemblera quand même à une tendance. Publier le score à côté de la tendance est ce qui évite à une équipe de passer un trimestre à courir après un mouvement qui n'a jamais existé.
De votre propre définition d'audience et de la demande de recherche observée, plutôt que d'un brainstorming. Vous décrivez votre profil client idéal une fois, les prompts sont générés depuis ces personas et depuis des données de requêtes réelles, et ils sont suggérés en masse pour que vous les éditiez, les gardiez ou les rejetiez. La raison est simple : une liste de prompts écrite depuis l'intérieur d'une entreprise pose surtout les questions que cette entreprise gagne déjà, ce qui produit une base flatteuse et aucune information.
Vous pouvez, et vous pouvez coller votre propre liste. Le problème n'est pas l'effort, c'est la sélection : une liste écrite depuis l'intérieur d'une entreprise pose les questions auxquelles cette entreprise répond déjà bien, donc la référence revient flatteuse et ne vous apprend rien d'actionnable. Générer depuis votre définition d'audience et la demande de recherche observée fait entrer dans le jeu les questions que vos acheteurs posent, y compris celles que vous perdez. Vous éditez, gardez ou rejetez chaque suggestion, et le score de qualité vous dira lesquels de vos propres prompts ne vous distinguent pas de vos concurrents.
Quatre axes sur une échelle de 0 à 1. La discriminance, la plus pondérée, mesure l'écart entre votre taux de mention et celui de vos concurrents sur ce prompt : une question que tout le monde gagne ne vous apprend rien. La stabilité mesure la variation de son taux de mention quotidien. L'actionnabilité indique si le prompt est relié à une recommandation que quelqu'un a réellement suivie. La récence indique s'il a été sondé dans les quinze derniers jours. En dessous de trois sondes extraites, le score est retenu plutôt qu'estimé.
Parce qu'ils répondent à des questions différentes. Avec la recherche activée, le moteur récupère des pages actuelles, donc le résultat reflète votre contenu et votre crawlabilité. Avec la recherche désactivée, il répond depuis ses données d'entraînement, donc le résultat reflète ce que le modèle croit déjà de vous. Fort avec recherche et faible sans signifie que vous êtes récupéré mais pas établi dans le modèle. L'inverse signifie que vous êtes établi mais pas récupéré, ce qui relève en général d'un problème de robots ou d'extractibilité.
Essai gratuit 14 jours
Essai gratuit 14 jours. Le suivi des prompts fait partie de la Visibilité IA, incluse dans chaque formule.